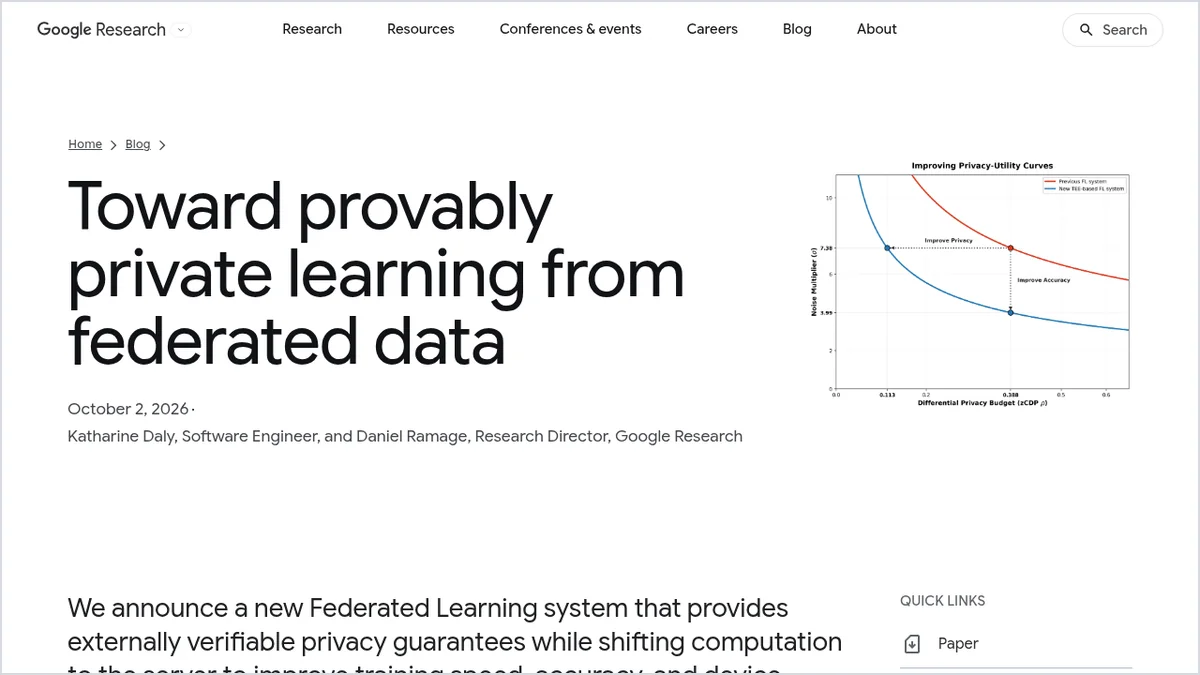
Google Research פרסמה ב־2 באוקטובר 2026 את הדור הבא של מערכת הלמידה המבוזרת (Federated Learning) שלה: אימון מודלים על נתונים שנשארים אצל המשתמשים, עם ערבויות פרטיות שאפשר לאמת מבחוץ. לפי ההודעה בבלוג המחקר הרשמי, המערכת החדשה נשענת על Trusted Execution Environments (TEEs), סביבות חומרה מוגנות בשרת, ומעבירה חלק גדול מהחישוב מהמכשיר אל השרת.
השינוי כבר לא רק על הנייר. גוגל כותבת ש־Gboard, מקלדת המקלדת שלה, כבר משתמשת במערכת החדשה לאימון מודלים לחיזוי המילה הבאה באנגלית וביפנית, עם פרטיות חזקה יותר ומהירות אימון גבוהה יותר מאשר במערכת הקודמת.
מה השתנה לעומת FL הקלאסי
בלמידה מבוזרת רגילה המכשיר מחשב עדכוני מודל מקומית ושולח רק סיכומים. גוגל מזכירה שהמערכת שלה כבר מפעילה תכונות כמו חיזוי מילה הבאה ו־Smart Compose ב־Gboard, הצעות תשובה ב־Messages, ו־Smart Text Selection באנדרואיד. הבעיה שנשארה: קשה לצד שלישי לאמת שהשרת באמת לא שומר או בודק את הנתונים הגולמיים.
במערכת החדשה המכשירים מצפינים דוגמאות אימון ומעלים אותן עם מדיניות גישה מוגדרת מראש: רשימת חישובים ב־TEE שמותר להריץ על הנתונים האלה. מפתחות הפענוח נשמרים במערכת ניהול מפתחות שרצה בעצמה בתוך מקבץ של TEEs, והיא מוסרת מפתח רק לעומסי עבודה שתואמים את המדיניות. בסוף התהליך השרת רואה בעיקר משקלי מודל אנונימיים ומדדים, לא את הנתונים הפרטיים.
שקיפות שאפשר לבדוק
גוגל מדגישה ארבעה עקרונות שמנחים את העבודה: צמצום נתונים, אנונימיזציה, שקיפות ושליטה, ואימות וביקורת. במערכת החדשה מדיניות הגישה מתפרסמת ליומן שקיפות ציבורי (Rekor), כך שבודקים חיצוניים יכולים לעקוב אחרי אילו עומסי עבודה המכשירים מאשרים. הבינארים של המערכת, לפי גוגל, ניתנים לבנייה חוזרת מקוד פתוח ב־Confidential Federated Compute.
כדי לאפשר ביקורת בלי לחשוף לוגיקה עסקית רגישה, ה־TEE תומך בטעינת חלקים מסוימים בזמן ריצה, בתנאי שהלוגיקה הרלוונטית לפרטיות נשארת מקודדת בתוכנית עצמה. גוגל מציינת גם מגבלות של דור ה־TEE הנוכחי, כולל סיכוני ערוצי צד.
למה זה משנה ל־Gboard
במערכת הישנה האימון היה תלוי בזמינות מכשירים לאורך היום, במשאבי חישוב על המכשיר ובתחרות בין כמה עומסי עבודה על אותם מכשירים. אימון מודל כזה יכול היה לקחת חודש־חודשיים. במערכת החדשה האיסוף קורה קודם, והאימון רץ בשרת עם מקביליות בין מכונות, כך שצוואר הבקבוק עובר לזמינות משאבי TEE.
גוגל מדווחת גם שאפשר לכוון טוב יותר את לוח הזמנים של השתתפות המכשירים בתוך תוכנית האימון, וכך לחזק את ערבויות הפרטיות הדיפרנציאלית או להקטין רעש, בלי לפגוע באותה מידת דיוק. התוצאה ב־Gboard: מודלים לחיזוי מילה הבאה עם פרטיות חזקה יותר ודיוק משופר, לדברי החברה.
מה עוד בדרך
העברת חישוב הגרדיאנטים לשרת פותחת, לפי גוגל, דלת לאימון מודלים גדולים יותר בלמידה מבוזרת, כולל שילוב עתידי של מאיצים בתוך TEEs. החברה מספרת שהיא גם מנסה עומסי עבודה אחרים על התשתית, כמו יצירת נתונים סינתטיים, ומשלבת את זה עם TEEs שמיועדים להסקה של מודלי שפה.
חשוב לקרוא את זה כהכרזה של Google Research על מערכת בייצור חלקי, לא כהבטחה שכל שירותי גוגל כבר מוגנים כך. למי שעוקב אחרי כיוון הפרטיות של גוגל, כדאי גם להכיר את SynthID Bio ואת Gemini 4 Argon. עדכונים נוספים במדור חדשות AI.
מקורות
- Google Research (Katharine Daly, Daniel Ramage), Toward provably private learning from federated data, 2 באוקטובר 2026: research.google/blog/toward-provably-private-learning-from-federated-data/