OpenAI פרסמה ב־5 באוקטובר 2026 את הדרך שבה היא מתכוונת לעמוד בדרישת חוק ה־AI של האיחוד האירופי (EU AI Act), שלפיה טקסט שנוצר בבינה מלאכותית צריך להיות ניתן לזיהוי על ידי מכונה. הפתרון שלה הוא סימן מים בלתי נראה בטקסט, והוא מגיע בשלבים: ללקוחות ה־API כבר מהיום כאפשרות, למשתמשי ChatGPT ו־Codex באיחוד האירופי בשבועות הקרובים, וגישה לכלי הזיהוי רק לחוקרים וארגונים מומחים שיאושרו.
כל המסלולים, המחירים והכתבות של מאיץ על ChatGPT מרוכזים בעמוד המרכז של ChatGPT.
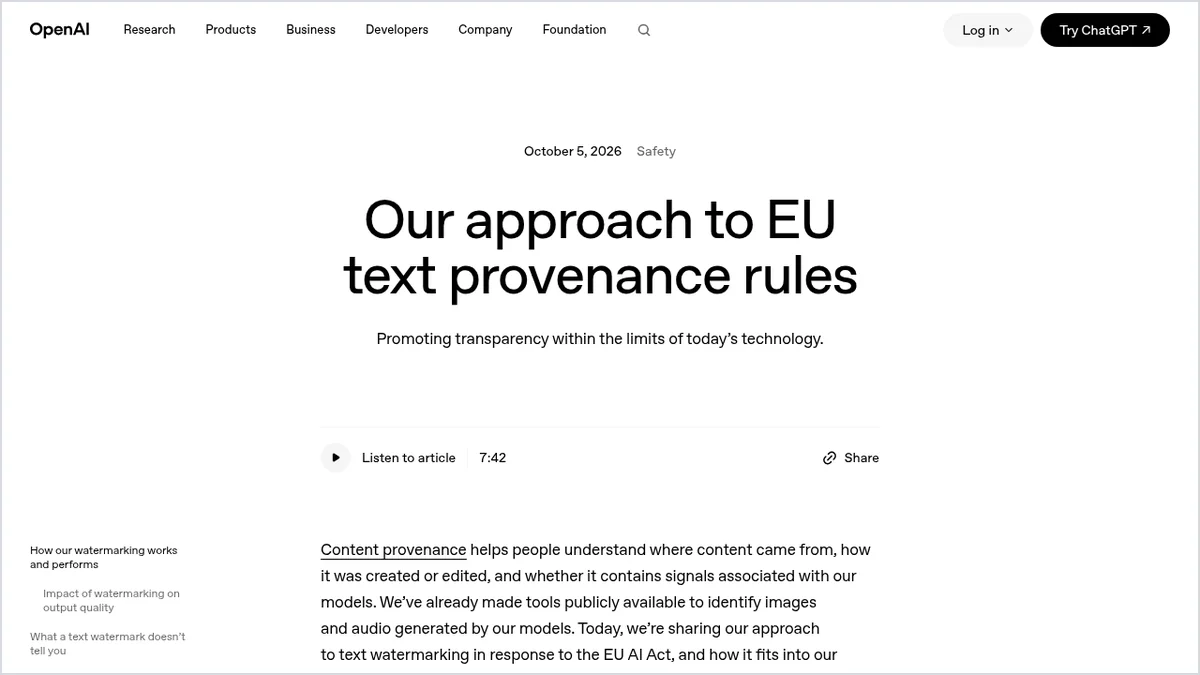
החברה עצמה מדגישה שסימון וזיהוי של טקסט הם עדיין טכנולוגיות מוקדמות עם מגבלות משמעותיות, ולכן היא בוחרת להתקדם בזהירות ולפרט במפורש מה סימן מים יכול לומר ומה לא.
מה משתנה ולמי
- לקוחות API בכל העולם: החל מהיום אפשר להפעיל סימון מים בטקסט שמחזירים חלק מהמודלים. ברירת המחדל ב־API נשארת כבויה. OpenAI עובדת גם עם ספקיות ענן כדי שהאפשרות תגיע למודלים שלה שנצרכים דרכן.
- ChatGPT ו־Codex באיחוד האירופי: בשבועות הקרובים יתווסף סימן מים בלתי נראה לטקסט שנוצר אצל משתמשים זכאים בכל התוכניות, באיחוד האירופי בלבד. OpenAI אומרת במפורש שהיא לא הופכת את זה לברירת מחדל גלובלית בשלב ההשקה.
- כלי הזיהוי: נפתחה הגשת בקשות לגישה, אבל היא תינתן בשלב ראשון רק לחוקרים ולארגונים מומחים, כל בקשה לגופה. הכלי מדווח אם זוהה סימן מים של OpenAI, בלי לזהות את המשתמש ובלי לחשוף פרומפטים או שיחות.
כלי האימות של OpenAI לתמונות ולאודיו, שכבר זמינים לציבור, ממשיכים לפעול כרגיל. השינוי נוגע רק לטקסט.
איך זה עובד: textGrain
הטכנולוגיה נקראת textGrain. היא מוסיפה אות סטטיסטי בלתי נראה לבחירת המילים של המודל, וגלאי מחפש את האות הזה כדי להעריך אם קטע טקסט נושא סימן מים של OpenAI. לפי החברה, בבדיקות שלה textGrain השתווה לשיטות אחרות או עלה עליהן, כולל SynthID לטקסט של Google (על הגישה של Google לסימון תוכן כתבנו גם בכתבה על SynthID Bio). OpenAI מתכננת להוציא את הטכנולוגיה בקוד פתוח ולעדכן את הדוח הטכני בשבועות הקרובים.
המספרים שמראים את המגבלות
מה שמעניין בהודעה הוא שהחברה מפרסמת גם את החולשות. כשהגלאי מכויל לשיעור התרעות שווא של 1%:
- בתוכן כמו פסיכולוגיה זוהה סימן מים בכ־80% מהקטעים באורך 200 טוקנים, ובכ־95% מהקטעים באורך 400 טוקנים.
- בתוכן מתמטי, שבו יש פחות חופש בבחירת מילים, שיעורי הזיהוי היו נמוכים בהרבה.
- עריכה מחלישה את הסימן: בקטעים של 400 טוקנים, החלפת 10% מהמילים במילים נרדפות הורידה את הזיהוי מכ־92% ל־66%, והחלפת 25% הורידה אותו ל־17%.
לגבי איכות התשובות, OpenAI מדווחת שבמבחנים שבהם היא בודקת את Astra, המודל המוביל שלה, לא נמצא הבדל משמעותי בין טקסט מסומן ללא מסומן. למשל ב־GPQA Diamond התוצאה הייתה 94.44% בלי סימן ו־93.94% עם סימן.
מה סימן מים לא אומר
OpenAI מקדישה חלק שלם להסבר שזיהוי סימן מים הוא אות מוגבל. הוא לא מודד כמה עבודה אנושית הושקעה בטקסט, לא קובע למי הטקסט שייך או מי אחראי לו, לא מזהה את המשתמש ולא מעיד אם התוכן נכון. וגם ההפך חשוב: היעדר סימן לא מוכיח שאדם כתב את הטקסט, כי טקסט קצר, ערוך או מתורגם עלול לא להיות מזוהה, וייתכן שהוא נוצר בכלי של חברה אחרת. זו הסיבה שהגלאי לא נפתח לציבור כבר עכשיו.
מה זה אומר למשתמשים בישראל
ישראל אינה חלק מהאיחוד האירופי, ולפי ההודעה הסימון ב־ChatGPT וב־Codex יחול בשלב זה רק על משתמשים באיחוד. כלומר, משתמשים בישראל לא אמורים לראות שינוי בינתיים. מי שבונה מוצר על ה־API, ובמיוחד חברה ישראלית שמשרתת לקוחות באירופה, יכול כבר עכשיו להפעיל את הסימון אם הוא רוצה לעמוד בדרישות השקיפות. עוד על המאמצים של OpenAI להגן על המודלים שלה תמצאו בכתבה על שיבוש קמפיין הזיקוק, ועוד עדכונים במדור חדשות AI.
מקורות
- OpenAI, הבלוג הרשמי: Our approach to EU text provenance rules, 5 באוקטובר 2026, openai.com/index/eu-text-provenance